
Què hi ha dins d’una IA: dels LLM als agents, i el que ve després
Una explicació clara de com funcionen per dins els models de llenguatge, per què els models actuals raonen abans de respondre i com es converteixen en agents. Amb l’estat de l’art el novembre de 2026, els seus límits i les tecnologies que venen.
Què hi ha dins d’una IA: dels LLM als agents, i el que ve després
Com funcionen ChatGPT, Claude o Gemini, per què els models actuals raonen, com es converteixen en agents que treballen per tu, on són els seus límits i quines tecnologies podrien succeir-los
Gairebé tots ja fem servir alguna intel·ligència artificial: per redactar un correu, resumir un PDF o preparar una presentació. Però poques persones saben què passa per dins quan escrivim una pregunta i apareix una resposta. I entendre-ho no és un capricci d’enginyers: saber com funciona una IA és la millor manera de saber quan fiar-se’n, quan no i com treure’n partit en una empresa.
Aquest article recorre sis etapes:
- Què és un LLM i com funciona per dins.
- Per què els models actuals raonen abans de respondre, i per què això canvia el que poden fer.
- Com un LLM es converteix en un agent que fa tasques.
- Quin és l’estat de l’art el novembre de 2026.
- Els seus límits teòrics i si som a prop d’assolir-los.
- Les tecnologies que podrien complementar-lo o substituir-lo, com els «models del món» de Yann LeCun.
1. Què és un LLM i com funciona per dins
LLM significa Large Language Model, «model de llenguatge gran». És un programa que ha après, a partir de quantitats enormes de text, a fer una sola cosa molt bé: predir quin és el fragment de text següent més probable. Tota la resta, des de respondre preguntes fins a escriure codi, surt d’aquesta habilitat aplicada una vegada i una altra.
1.1. Tokens: el text trossejat
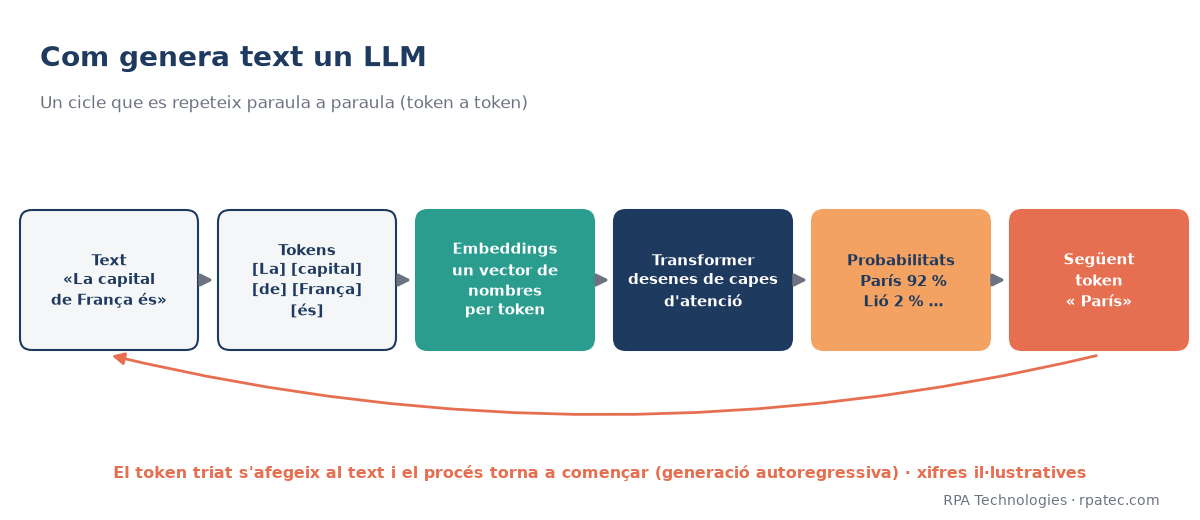
El model no llegeix lletres ni paraules completes, sinó tokens: trossos de text que poden ser una paraula curta («la»), part d’una paraula llarga («intel» + «ligència») o un signe de puntuació. Cada model té un vocabulari fix de tokens i converteix qualsevol text en una llista de nombres d’aquest vocabulari.
Per això els preus de les IA s’expressen en «milions de tokens». I per això els models antics fallaven sovint en comptar les lletres d’una paraula: mai no van veure les lletres, van veure els trossos (ho reprenem a la secció 2).
1.2. Embeddings: el significat convertit en nombres
Cada token es transforma en un embedding: una llista llarga de nombres (milers) que representa el seu significat com un punt en un espai de moltes dimensions. Durant l’entrenament, les paraules que apareixen en contextos semblants acaben en punts propers: «factura» queda a prop de «rebut» i lluny de «muntanya».
Aquesta idea és també la base del RAG (cerca en els teus propis documents), del qual parlarem en propers articles: si els significats són punts, cercar informació rellevant és cercar punts propers.
1.3. El transformer i l’atenció: llegir en context
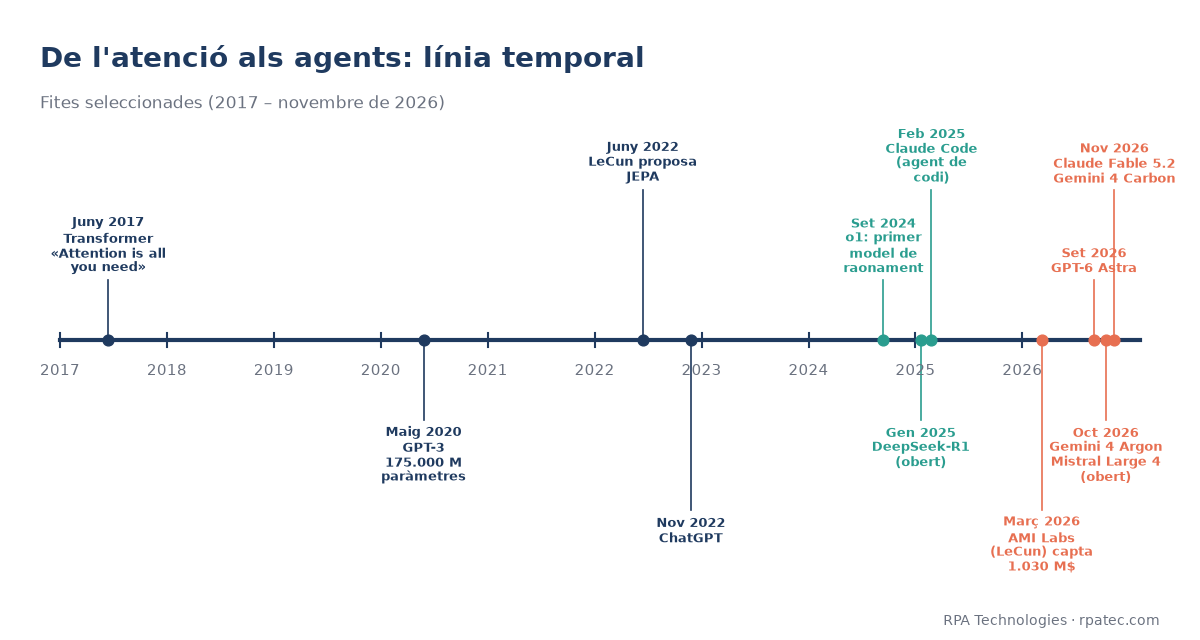
El cor de gairebé tots els LLM actuals és el transformer, una arquitectura presentada per investigadors de Google el 2017 en l’article Attention Is All You Need. La seva peça clau és el mecanisme d’atenció.
L’atenció resol un problema simple d’enunciar: el significat d’una paraula depèn de les altres. A «Ana va deixar el portàtil a la taula perquè estava trencat», què estava trencat? Per interpretar «estava», el model calcula quant ha de «mirar» cadascuna de les paraules anteriors i en barreja la informació en aquesta proporció.
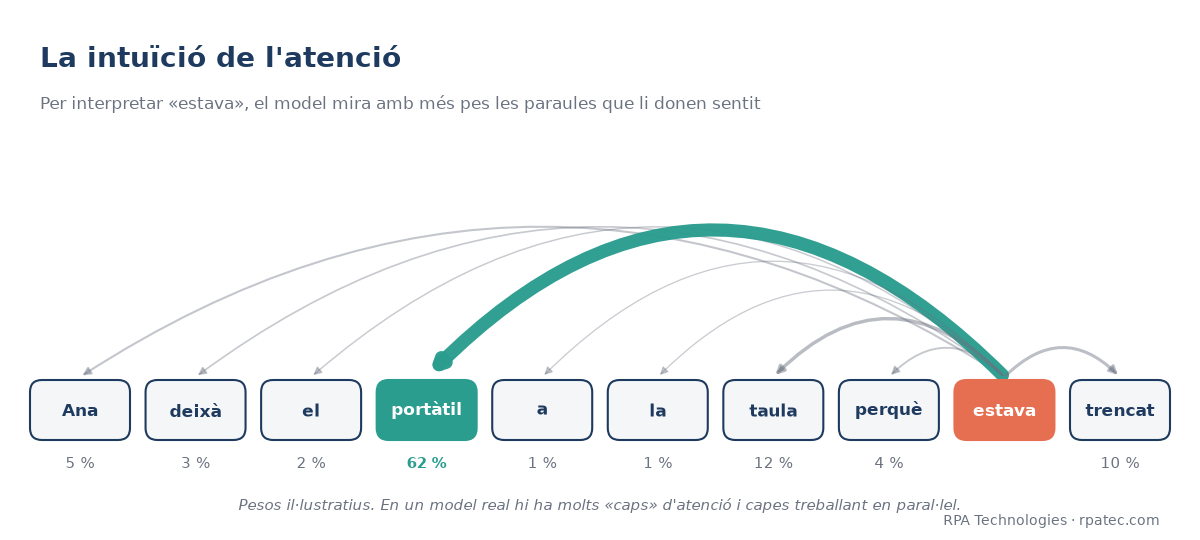
El mecanisme real és matemàtic: cada token genera tres vectors (una «pregunta», una «clau» i un «valor»); la pregunta d’un token es compara amb les claus de tots els altres, i com més s’assemblen, més pes rep el seu valor. Això es repeteix en molts «caps» en paral·lel (un es pot fixar en la gramàtica, un altre en qui fa què) i en desenes de capes apilades. Capa a capa, la representació de cada token es va enriquint amb el context.
Al final, el model produeix una puntuació per a cada token possible del vocabulari, que es converteix en probabilitats. Se’n tria un (no sempre el més probable: una mica d’atzar, l’anomenada «temperatura», fa les respostes més naturals), s’afegeix al text i es repeteix tot el procés. Una resposta de 500 paraules són centenars de voltes d’aquest cicle.
1.4. Com aprèn: les etapes d’entrenament
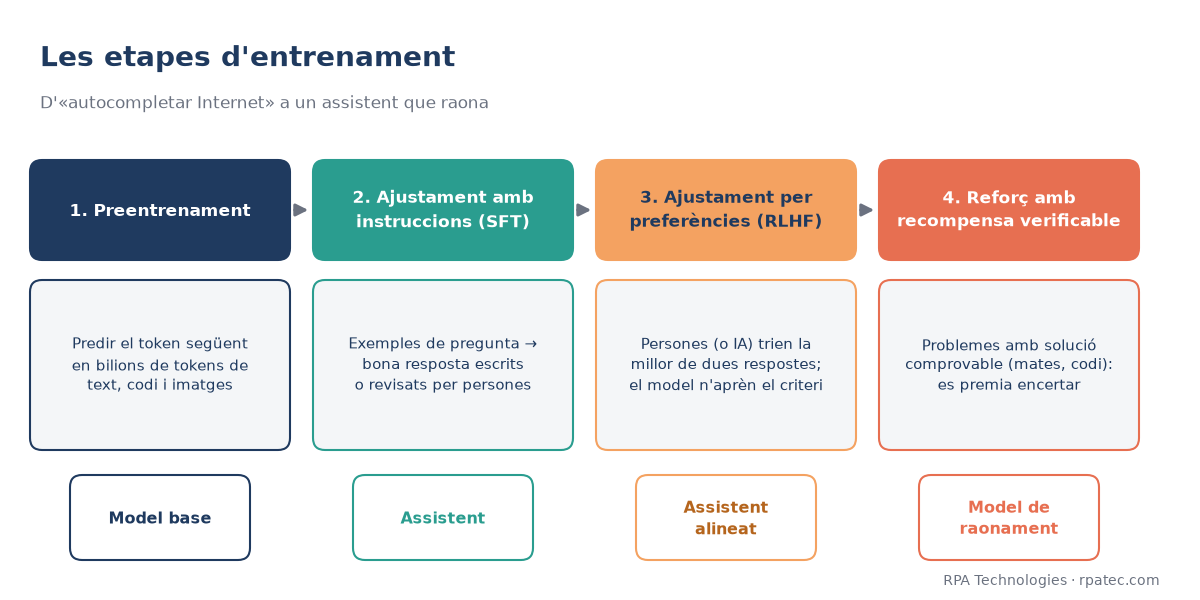
Preentrenament. El model comença amb milers de milions de paràmetres (els «dials» interns) amb valors aleatoris. Se li mostra text real amb l’última paraula tapada; prediu, es compara amb la paraula correcta i s’ajusten lleugerament tots els paràmetres perquè la propera vegada encerti una mica més. Repetit bilions de vegades sobre text, codi i imatges, el model acaba absorbint gramàtica, dades del món i patrons de raonament. El resultat és un model base: un autocompletador molt culte, però que no sap conversar.
Ajustament amb instruccions (SFT). Se l’entrena amb milers d’exemples de «petició → bona resposta» escrits o revisats per persones. Aprèn el format d’assistent.
Ajustament per preferències (RLHF). Persones (i cada vegada més, altres IA) comparen dues respostes i trien la millor. El model n’aprèn el criteri: ser útil, honest, no nociu. És una de les raons per les quals els assistents sonen tan amables i, de vegades, tan complaents.
Reforç amb recompenses verificables. És l’etapa més recent i la que ha donat lloc als models raonadors. Per la seva importància, hi dediquem la secció 2.
1.5. Finestra de context
La finestra de context és la quantitat màxima de tokens que el model pot tenir davant alhora: la teva pregunta, els documents adjunts, la conversa prèvia i la seva pròpia resposta. És la seva memòria de treball. Els models de gamma alta actuals manegen al voltant d’un milió de tokens (per exemple, Claude Fable 5.2 o Mistral Large 4), de l’ordre d’uns quants llibres. Fora d’aquesta finestra, el model no recorda res: no aprèn de les teves converses tret que el sistema que l’envolta en desi notes i les hi torni a mostrar.
💊 Píndola de coneixement
Un LLM no «cerca» respostes: prediu el token següent, una vegada i una altra, fent servir l’atenció per llegir cada paraula en el seu context. El que sap ho va absorbir en entrenar-se; el que té davant a la finestra de context és la seva única memòria de treball.
2. Models raonadors: la baula entre predir paraules i fer feina de veritat
Fins al 2024, un LLM responia d’una tirada: llegia la pregunta i començava a escriure la resposta. Els models punters d’avui no funcionen així. Abans de respondre, pensen. I entendre aquesta diferència és clau, perquè els models de frontera actuals ja no són «simples LLM»: el raonament és el que els permet fer servir eines amb fiabilitat i resoldre problemes complexos, i per tant el que fa possibles els agents de la secció següent.
2.1. Com funcionen
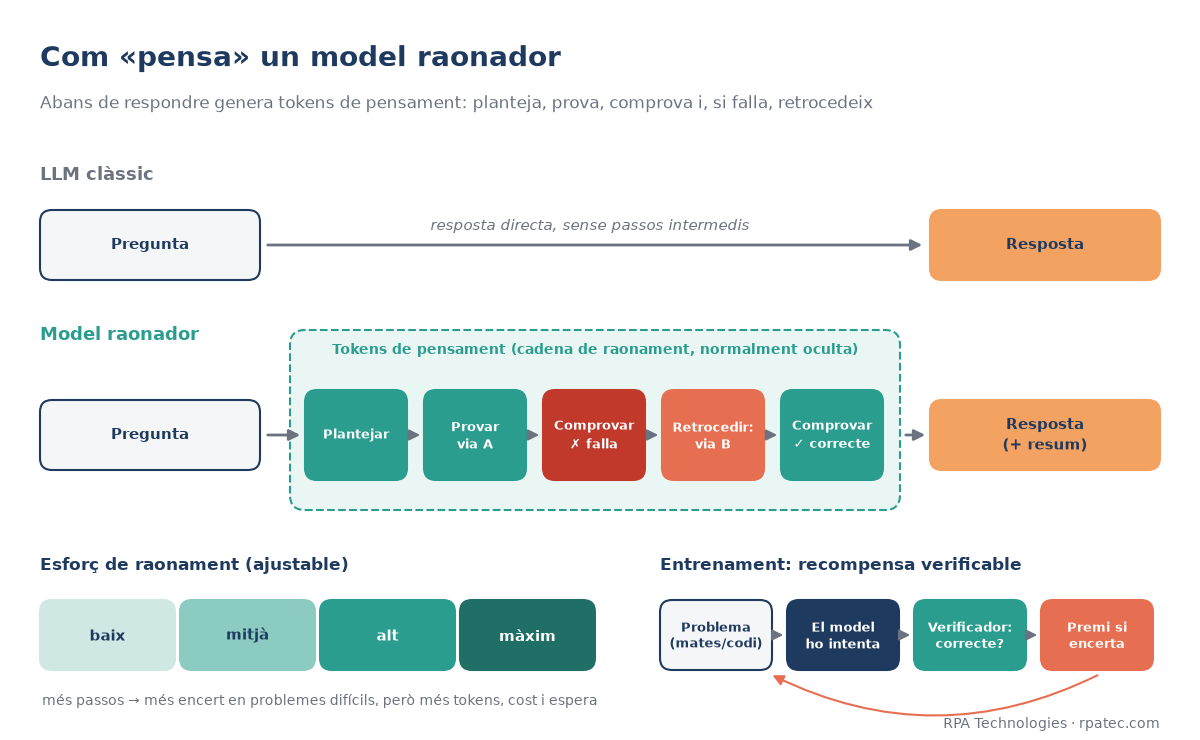
Tokens de pensament. Un model raonador continua predient tokens, però abans de la resposta genera una cadena de raonament (chain of thought): planteja el problema, el divideix en passos, prova una via, la comprova i, si falla, retrocedeix i en prova una altra. Aquests passos ocupen espai a la finestra de context i normalment només en veus un resum. Així ho va presentar OpenAI amb o1, el setembre de 2024.
Còmput en el moment de respondre (test-time compute). La gran novetat és que hi ha una segona manera de fer un model més llest: no només entrenar-lo més, sinó deixar-lo pensar més temps en cada pregunta.
Reforç amb recompenses verificables. Com s’aprèn a pensar bé? Se li donen problemes la solució dels quals es pot comprovar automàticament (un resultat matemàtic, un codi que ha de passar unes proves) i es premien els intents que encerten: es premia encertar, no semblar correcte. Ningú no li ensenya com raonar; descobreix quines estratègies funcionen. En el cas de DeepSeek-R1-Zero (gener de 2025), entrenat només amb reforç, els seus autors van observar que el model va començar per si mateix a aturar-se i revisar el seu raonament, cosa que van anomenar un «moment ahà».
Autoverificació i retrocés. El model aprèn a comprovar els resultats intermedis abans de continuar, així que un error primerenc ja no malmet tota la resposta.
Esforç ajustable. Gairebé tots els models actuals permeten triar quant pensen (baix, mitjà, alt, màxim). Més esforç significa més encert en problemes difícils, però també més tokens, més cost i més espera.
2.2. Un exemple quotidià: quantes erres té «strawberry»?
Durant anys, una pregunta tan senzilla com «quantes erres té la paraula anglesa strawberry?» feia ensopegar models molt coneguts, que sovint responien «dues». L’explicació és a la secció 1: el model no rep lletres, sinó tokens. Strawberry li arriba en uns quants trossos (per exemple, «str» + «aw» + «berry»), de manera que mai no «veu» les lletres soltes i ha d’endevinar-ne quantes n’hi ha.
Aquesta fallada era típica, sobretot, dels models antics, sense raonament, que contestaven d’una tirada. Els raonadors actuals gairebé sempre encerten, i no perquè hagin deixat de fer servir tokens, sinó perquè lletregen la paraula pas a pas (s-t-r-a-w-b-e-r-r-y) abans de comptar, o recorren a una eina, com un petit programa, que compta per ells. És un bon exemple de com el raonament compensa un límit de la pròpia arquitectura.
2.3. El salt en els resultats
- Matemàtiques (AIME 2024): GPT-4o resolia de mitjana el 12 % dels problemes d’aquest examen d’olimpíada; o1, el 74 % amb un sol intent. En ciència de nivell de doctorat (GPQA Diamond), o1 va arribar al 78 % davant del 56 % de GPT-4o i, segons OpenAI, va ser el primer model a superar en aquesta prova els experts amb doctorat que la pròpia empresa va reclutar per comparar-s’hi.
- DeepSeek-R1 (gener de 2025, model obert) va assolir el 79,8 % en AIME 2024. La seva versió entrenada només amb reforç (R1-Zero) va passar del 15,6 % al 71 % durant l’entrenament, segons l’informe de gener de 2025; en la versió revisada que es va publicar a Nature el setembre de 2025, R1-Zero arriba al 77,9 %.
- ARC-AGI (raonament abstracte, fàcil per a persones i difícil per a màquines): en ARC-AGI-1, GPT-4o rondava el 5 % el 2024; el desembre d’aquell any, una versió preliminar d’o3 (o3-preview) va marcar un 75,7 %. Quan es va llançar la versió ARC-AGI-2, més difícil (març de 2025), els LLM sense raonament treien un 0 % i els raonadors, un sol dígit. Avui, segons la classificació del mateix ARC Prize (consultada l’11 de novembre de 2026), l’encapçala GPT-6 Astra amb un 95 %, seguit de GPT-6.1 Sol i Gemini 4 Carbon (94,2 % cadascun) i Claude Fable 5.2 (93,8 %).
- Programació real (SWE-bench Verified), que consisteix a resoldre incidències reals de projectes de programari: GPT-4o resolia el 33,2 % l’agost de 2024 i DeepSeek-R1 va arribar al 49,2 % el gener de 2025. En l’avaluació independent de Vals AI (actualitzada l’1 de setembre de 2026), Claude Opus 5 va resoldre el 97 %, fins al punt que Vals va deixar de fer servir aquesta prova perquè estava saturada. Les xifres depenen de qui mesura i amb quin harness: el tauler oficial de SWE-bench, que s’actualitza amb menys freqüència, mostra un màxim del 79,2 %.
2.4. El preu de pensar
Pensar costa, perquè els tokens de pensament es paguen com a text generat encara que no els vegis. El cas més il·lustratiu és aquella versió preliminar d’o3 en ARC-AGI-1 (desembre de 2024): segons les estimacions d’ARC Prize, un 75,7 % costava uns 26 $ per tasca; pujar al 87,5 % va exigir unes 172 vegades més còmput, uns 4.560 $ per tasca. El cost ha baixat molt des d’aleshores, però la lògica continua sent la mateixa: més encert a canvi de més diners i més segons (o minuts) d’espera. Per a preguntes senzilles, un nivell d’esforç baix sol bastar.
2.5. Els seus límits
- Capacitats irregulars. Els models resolen problemes de matemàtiques d’olimpíada i, alhora, fallen en tasques que a una persona li semblen trivials. Les capacitats són irregulars (jagged, diu METR): brillants en tasques ben definides i comprovables, on el reforç funciona millor (matemàtiques, codi), i més maldestres en tasques ambigües, llargues i amb poc context, que són justament les del dia a dia d’una empresa. Aquí la millora és menor i la revisió humana continua sent imprescindible.
- El raonament visible no sempre és el real. En un estudi d’Anthropic de 2025, quan als models se’ls donava una pista amb la resposta i la feien servir, només l’esmentaven en el seu raonament el 25 % de les vegades (Claude 3.7 Sonnet) i el 39 % (DeepSeek-R1). La cadena de pensament ajuda a supervisar, però no és una confessió fidel.
- Sobrepensar. Els raonadors de vegades gasten centenars de tokens en preguntes trivials, com descriu l’estudi Do NOT Think That Much for 2+3=? (2024).
2.6. Per què importa per als agents
Un agent encadena desenes de passos: cercar una dada, obrir un fitxer, executar un càlcul, comprovar el resultat. Si cada pas té una petita probabilitat d’error, sense capacitat de detectar-lo i corregir-lo la fallada s’acumula. El raonament aporta justament això: planificar abans d’actuar, comprovar el que retorna cada eina i rectificar. És el pont entre «predir la paraula següent» i «acabar una feina».
💊 Píndola de coneixement
Els models de frontera actuals pensen abans de respondre: generen passos intermedis, els comproven i rectifiquen. Ho van aprendre amb reforç sobre problemes verificables, i és el que els permet fer servir eines amb fiabilitat. Pots regular quant pensen: més esforç dona més encert, però també més cost i més espera.
3. De LLM a agent: el paper del «harness»
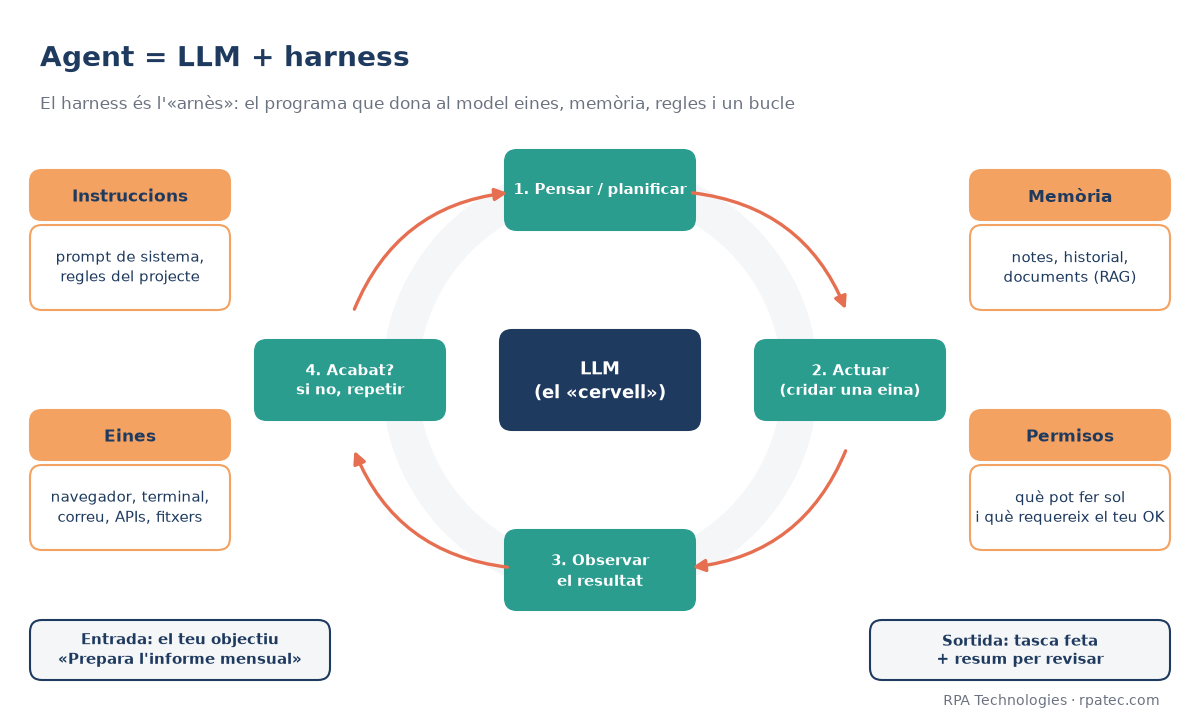
Un LLM, tot sol, només produeix text. No pot obrir el teu correu, consultar una base de dades ni desar un fitxer. Perquè faci coses necessita un harness (literalment, «arnès»): el programa que l’envolta i el connecta amb el món.
Un harness té cinc peces:
- El bucle. El harness passa al model l’objectiu, el model decideix un pas, el harness l’executa, en retorna el resultat al model i es repeteix fins a acabar. Aquest cicle de pensar → actuar → observar és el que converteix una resposta en una feina.
- Eines. Funcions que el model pot demanar que s’executin: cercar al web, llegir un PDF, llançar una ordre, enviar un esborrany. El model no les executa: escriu una petició estructurada («crida cerca_factura amb el client X») i el harness l’executa. Des de finals de 2024 existeix un estàndard obert, el Model Context Protocol (MCP), que permet connectar eines a gairebé qualsevol agent.
- Instruccions. El «prompt de sistema» i els fitxers de regles del projecte: qui és, com treballa, quin estil fa servir.
- Memòria. Notes que l’agent desa i rellegeix, historial o documents indexats. Com que el model oblida tot el que queda fora de la seva finestra de context, la memòria la gestiona el harness.
- Permisos. Què pot fer sol i què necessita la teva aprovació. És la peça més important en una empresa: un agent amb accés al teu correu sense control de permisos és un risc.
Una dada reveladora: el mateix model rendeix de manera molt diferent segons el harness. Per això organitzacions d’avaluació com METR proven els models dins de diferents harness (per exemple, Claude Code o Codex) abans de mesurar el que són capaços de fer.
Exemples disponibles avui (novembre de 2026)
- Agents de programació: Claude Code (Anthropic), Codex (OpenAI, amb una versió de línia d’ordres de codi obert), Cursor (editor amb agents locals i al núvol) i Antigravity (Google). Llegeixen un projecte sencer, modifiquen fitxers, executen proves i proposen canvis per a revisió.
- Agents de treball general al núvol: Manus, Claude Cowork, Dots d’OpenAI, Muse de Meta o Grok Bot. Tenen el seu propi ordinador virtual amb navegador i fitxers, i fan tasques com investigar, omplir fulls de càlcul o preparar informes.
- Agents de codi obert i autoallotjats: OpenClaw i Hermes Agent (de Nous Research), tots dos amb llicència MIT. S’instal·len al teu ordinador o servidor, admeten molts models (inclosos models locals) i es controlen des de WhatsApp, Telegram, Slack o Teams. Són interessants quan la privadesa i el control de les dades importen.
- Plataformes empresarials: Mistral, per exemple, va anunciar el 5 de novembre Mistral Studio per crear agents gestionats, al seu núvol o als teus propis servidors.
💊 Píndola de coneixement
Agent = LLM + harness. El model decideix; el harness executa, recorda i posa límits. Quan avaluïs una eina d’IA per a la teva empresa, pregunta tant pel model com pel harness: quines eines fa servir, on desa la memòria i què pot fer sense demanar-te permís.
4. L’estat de l’art el novembre de 2026
El ritme és vertiginós: només en la primera quinzena de novembre han sortit diversos models punters. Aquesta és una foto, no una classificació definitiva.
Els models de frontera (tancats):
- Google · Gemini 4 Carbon (10 de novembre) i Gemini 4 Argon (13 d’octubre). Carbon està orientat a tasques agèntiques llargues i ciberseguretat, i encapçala la classificació de text de LMArena, on persones voten a cegues entre dues respostes, amb 1.526 punts (dades del 9 de novembre), per davant d’Argon (1.522).
- Anthropic · Claude Fable 5.2 (9 de novembre), amb un milió de tokens de context, fins a 128.000 de sortida i raonament adaptatiu, a 8 $/40 $ per milió de tokens d’entrada/sortida. Anthropic afirma que en les seves proves prèvies va formalitzar la demostració de l’últim teorema de Fermat en 30 hores. És una afirmació de l’empresa, pendent de verificació independent. El seu bessó Mythos 5.2 només s’ofereix a organitzacions verificades en ciberseguretat i biomedicina.
- OpenAI · GPT-6 Astra (3 de setembre) i GPT-6.1 Sol (29 de setembre), que segons OpenAI gairebé iguala Astra en programació agèntica a una cinquena part del preu. GPT-6 Cyber (5 de novembre) està restringit a clients aprovats.
- Meta · Muse (Muse Wonder, Muse Spark) i xAI · Grok 4.7 (21 de setembre).
Els models oberts (pesos descarregables, que pots executar als teus servidors) són a poca distància: Mistral Large 4, europeu, alliberat el 29 d’octubre, amb un bilió de paràmetres (dels quals només uns 50.000 milions treballen en cada token, gràcies a la tècnica Mixture of Experts) i un milió de tokens de context. L’acompanyen Kimi K3, GLM 5.3, DeepSeek V4 o Qwen 3.8. A LMArena, el millor model obert (Kimi K3) és uns 40 punts per sota del primer.
Tres tendències que importen a una pime:
- La capacitat de treball autònom creix de manera exponencial. METR mesura la durada de les tasques (mesurada en temps d’un expert humà) que un agent completa amb un 50 % d’èxit. En la seva actualització de gener de 2026, aquesta durada es duplicava cada ~196 dies des de 2019 i cada ~89 dies des de 2024. METR ja adverteix que els seus mesuraments per sobre de 16 hores no són fiables amb la seva bateria de tasques actual: els millors models s’estan quedant sense examen.
- El preu per capacitat cau. Models intermedis com GPT-6.1 Sol (2 $/10 $ per milió de tokens) rendeixen gairebé com els de gamma alta de fa unes setmanes.
- El que és obert arriba al que és tancat amb uns mesos de retard, la qual cosa fa viable la IA local per a dades sensibles.
💊 Píndola de coneixement
Avui no hi ha un «millor model» únic: Google lidera en preferència d’usuaris, Anthropic i OpenAI competeixen en agents i programació, i els models oberts (com l’europeu Mistral Large 4) són a pocs mesos. Per a una empresa, la pregunta útil no és «quin és el millor?», sinó «quin és suficient per a aquesta tasca, a quin cost i amb quina privadesa?».
5. Límits teòrics: som a prop del sostre?
5.1. Al·lucinacions
Un LLM pot afirmar amb total seguretat una cosa falsa. No és una fallada puntual, sinó una conseqüència del seu disseny: el model genera el text més plausible, i el que és plausible no sempre és veritat. Un article d’OpenAI de setembre de 2025 afegeix una causa: els exàmens amb què s’avaluen els models premien encertar i no donen res per dir «no ho sé», així que l’entrenament recompensa endevinar. La seva proposta és penalitzar més l’error segur que l’abstenció.
Ha millorat molt, però no ha desaparegut. En la prova AA-Omniscience d’Artificial Analysis, fins i tot un model punter com GPT-6.1 Sol, quan no coneix la resposta, s’absté només al voltant de la meitat de les vegades; la resta, inventa. Conclusió pràctica: per a dades de la teva empresa, la IA ha de citar documents (RAG) i una persona ha de revisar el que és important.
5.2. No hi ha un model del món… o no del tot
Un LLM aprèn del llenguatge, que és una descripció parcial del món. Sap que un got que cau «es trenca» perquè ho ha llegit mil vegades, no perquè entengui la gravetat. Aquest és l’argument central de Yann LeCun: el text és massa pobre per aprendre física, causalitat i planificació com ho fa un infant observant. El debat continua obert: els models actuals, entrenats també amb imatges i vídeo, mostren una certa comprensió física, però fràgil.
5.3. El mur de dades
Epoch AI estima que el text públic de qualitat escrit per humans s’esgotarà com a recurs d’entrenament cap al 2028 (en un interval de 2026 a 2032). La indústria respon amb dades sintètiques (generades per altres IA), amb dades privades i multimodals (vídeo, àudio) i, sobretot, amb aprenentatge per reforç, on el model genera els seus propis intents i aprèn dels que funcionen. El mur existeix, però s’està vorejant.
5.4. Lleis d’escala, còmput i energia
Des de 2020 se sap que els models milloren de manera previsible en augmentar paràmetres, dades i còmput, però amb rendiments decreixents: cada millora costa moltes vegades més. El cost físic és real: l’Agència Internacional de l’Energia (IEA) preveu que el consum elèctric dels centres de dades passi d’uns 415 TWh el 2024 a uns 945 TWh el 2030, una mica menys del 3 % de l’electricitat mundial. La IA és el principal motor d’aquest augment.
El raonament i el reforç (secció 2) han obert noves palanques de millora, però també consumeixen còmput: pensar més temps en cada resposta multiplica la despesa.
5.5. El context no és memòria perfecta
Que un model accepti un milió de tokens no significa que els faci servir tots igual de bé. L’estudi Context Rot de Chroma (juliol de 2025) va provar 18 models i va veure que tots rendeixen pitjor a mesura que creix l’entrada, fins i tot en tasques senzilles. Per això un bon agent no «ho fica tot al context»: selecciona, resumeix i cerca el que és rellevant. Això s’anomena enginyeria de context.
A prop del sostre?
Les mètriques de capacitat no mostren estancament: l’horitzó de tasques de METR continua creixent exponencialment i els models de novembre superen els de setembre. Però les limitacions estructurals (al·lucinació, manca d’un model físic del món, aprenentatge que s’atura després de l’entrenament, capacitats irregulars i cost energètic) no es resolen només amb escala. La lectura més honesta és: queda molt marge de millora dins del paradigma actual, però probablement no basta per arribar a una intel·ligència general. D’aquí l’interès per les alternatives.
💊 Píndola de coneixement
Les IA actuals continuen millorant molt de pressa, però arrosseguen límits de disseny: inventen quan no saben, aprenen del text i no del món, i consumeixen molta energia. Per a la teva empresa: fes-les servir amb fonts citades, revisió humana en el que és crític i una bona gestió del context.
6. El que ve: tecnologies que poden complementar o substituir els LLM
6.1. JEPA i els models del món de Yann LeCun
Yann LeCun, premi Turing i durant anys cap científic d’IA a Meta, va deixar la companyia el novembre de 2025 i va fundar a París AMI Labs (Advanced Machine Intelligence). El març de 2026 l’empresa va captar 1.030 milions de dòlars amb una valoració prèvia de 3.500 milions, amb oficines a París, Nova York, Mont-real i Singapur. El seu objectiu declarat: sistemes que entenguin el món, tinguin memòria persistent, raonin, planifiquin i siguin controlables.
La seva proposta tècnica és JEPA (Joint Embedding Predictive Architecture), presentada per LeCun el 2022.
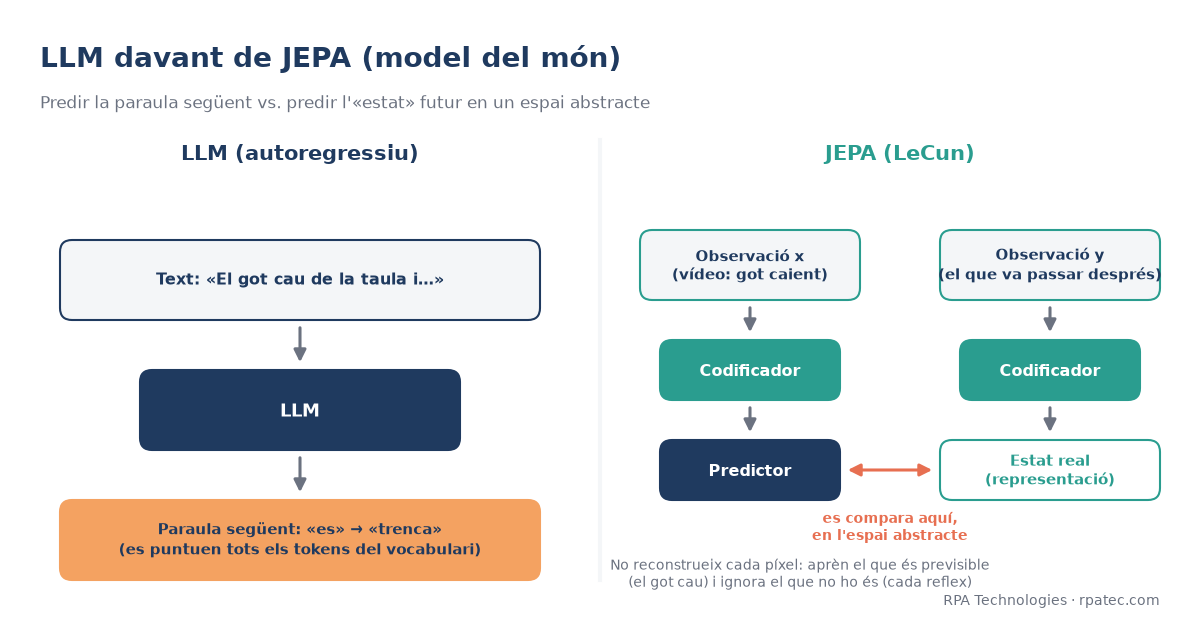
La diferència clau: un LLM prediu el token següent, és a dir, el detall exacte. JEPA no intenta predir cada píxel del fotograma següent d’un vídeo, perquè el món real té infinits futurs possibles i la majoria dels seus detalls (el reflex exacte en un vidre) són imprevisibles. En el seu lloc, converteix l’observació actual i la futura en representacions abstractes i aprèn a predir-ne una a partir de l’altra en aquest espai abstracte. Així es queda amb el que és previsible (el got cau) i ignora el soroll. Amb un model així, un sistema pot planificar: imaginar les conseqüències de diverses accions i triar la millor.
Hi ha resultats concrets: V-JEPA 2 (Meta, juny de 2025), entrenat amb vídeo i ajustat amb només 62 hores de dades de robots, va aconseguir que braços robòtics agafessin i col·loquessin objectes en laboratoris nous sense entrenament específic, amb taxes d’èxit del 65-80 % en aquesta tasca. Però AMI Labs reconeix que està en fase de recerca, sense productes a curt termini: primer publicacions científiques i després aplicacions industrials (fabricació, automoció, aeronàutica, salut) amb socis com l’empresa de salut digital Nabla.
6.2. Altres línies que convé conèixer
- Models basats en energia (EBM). Una altra idea defensada per LeCun: en lloc de generar una resposta, el sistema puntua com «encaixa» cada resposta possible amb la pregunta (energia baixa significa compatible) i cerca la millor. Permet raonar com a optimització, no només com a escriptura paraula a paraula.
- Models d’espai d’estats (SSM, com Mamba). Substitueixen o combinen l’atenció amb una «memòria comprimida» que s’actualitza pas a pas. El seu cost creix de manera lineal amb la longitud del text, en lloc de disparar-se com en l’atenció clàssica. Ja existeixen models híbrids transformer + Mamba en producció.
- Models de llenguatge de difusió. En lloc d’escriure d’esquerra a dreta, generen un esborrany complet i el refinen en paral·lel, com els generadors d’imatges. Són molt més ràpids. Exemples: Mercury, d’Inception, i l’experimental Gemini Diffusion de Google.
- IA neurosimbòlica. Combina xarxes neuronals amb lògica formal i regles verificables. Ja la veiem a la pràctica: models que escriuen demostracions en llenguatges formals (com Lean) que un verificador automàtic comprova. És una via directa contra les al·lucinacions en tasques on la correcció importa.
Substituir o complementar? El més probable a mitjà termini és una combinació: LLM com a interfície de llenguatge i orquestrador, models del món per al que és físic i la planificació, verificadors simbòlics per al que ha de ser exacte, i arquitectures més eficients per abaratar el cost. Els agents d’avui ja funcionen així: un model que coordina eines especialitzades.
💊 Píndola de coneixement
Yann LeCun aposta pels models del món (JEPA) que aprenen observant i prediuen en abstracte, no paraula a paraula. És recerca prometedora, amb robots que ja planifiquen tasques senzilles, però encara sense productes. El futur probable no és «LLM o alternativa», sinó sistemes híbrids.
En resum
- Un LLM prediu el token següent fent servir l’atenció sobre el seu context. Tota la resta es construeix a sobre.
- Els models raonadors pensen abans de respondre: generen passos intermedis, els comproven i rectifiquen. Per això els models de frontera ja no són «simples LLM».
- Un agent és un LLM amb un harness: bucle, eines, memòria, instruccions i permisos.
- El novembre de 2026 la frontera la marquen Google, Anthropic i OpenAI, amb els models oberts a pocs mesos, la qual cosa obre la porta a la IA privada i local.
- Els límits (al·lucinacions, dades, energia, comprensió del món) són reals, però encara hi ha marge dins del paradigma actual.
- El que ve (models del món, SSM, difusió, neurosimbòlica) apunta a sistemes híbrids.
A RPA Technologies ajudem pimes i professionals a aplicar tot això amb els peus a terra: assistents i agents que treballen amb els teus documents, IA local quan la privadesa ho exigeix, i formació perquè el teu equip entengui el que fa servir. Si vols que tractem un tema concret, deixa-ho als comentaris.
👉 Més informació a rpatec.com
Fonts
Ordenades segons apareixen a l’article. Dades de classificacions consultades l’11-11-2026.
- Vaswani et al., Attention Is All You Need (2017): https://arxiv.org/abs/1706.03762
- OpenAI, Learning to reason with LLMs (12-9-2024): https://openai.com/index/learning-to-reason-with-llms/
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (1-2025): https://arxiv.org/abs/2501.12948 · versió revisada a Nature (9-2025), taula per etapes: https://www.nature.com/articles/s41586-025-09422-z/tables/2
- ARC Prize, OpenAI o3 Breakthrough High Score on ARC-AGI-Pub (20-12-2024): https://arcprize.org/blog/oai-o3-pub-breakthrough
- ARC Prize, Announcing ARC-AGI-2 and ARC Prize 2025 (24-3-2025): https://arcprize.org/blog/announcing-arc-agi-2-and-arc-prize-2025
- ARC Prize, classificació i resultats: https://arcprize.org/leaderboard · https://arcprize.org/results
- OpenAI, Introducing SWE-bench Verified (13-8-2024): https://openai.com/index/introducing-swe-bench-verified/
- Vals AI, SWE-bench Verified (arxivat; actualitzat l’1-9-2026): https://www.vals.ai/benchmarks/swebench
- SWE-bench, taulers oficials: https://www.swebench.com/
- METR, Time Horizon 1.1 (29-1-2026): https://metr.org/blog/2026-01-29-time-horizon-1-1/ · https://metr.org/time-horizons/
- Anthropic, Reasoning models don’t always say what they think (2025): https://www.anthropic.com/research/reasoning-models-dont-say-think · https://arxiv.org/abs/2505.05410
- Chen et al., Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs (12-2024): https://arxiv.org/abs/2412.21187
- Comparatives d’agents i harness (2026): https://hermes-agent.nousresearch.com/compare · https://insights.reinventing.ai/ai-agent-harnesses
- Mistral Studio i llançaments de novembre (recopilació): https://ai.vi.ki/releases
- Google, Gemini 4 Carbon is now available (10-11-2026): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- Google, Gemini 4 Argon (13-10-2026): https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/
- LMArena Text leaderboard (via BenchLeader, dades del 9-11-2026): https://www.benchleader.com/benchmarks/lmarena_text
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2 (9-11-2026): https://www.anthropic.com/claude-fable-and-mythos-5-2 · fitxa tècnica: https://platform.claude.com/docs/en/models/fable-5-2/overview
- OpenAI, GPT-6 Astra (3-9-2026): https://openai.com/index/gpt-6-astra/ · Introducing GPT-6.1 Sol (29-9-2026): https://openai.com/index/introducing-gpt-6-1-sol/
- xAI, Introducing Grok 4.7: https://x.ai/news/grok-4-7
- Mistral AI, Mistral Large 4 is now open weight (29-10-2026): https://mistral.ai/news/mistral-large-4-oss/
- OpenAI, Why language models hallucinate (9-2025): https://openai.com/index/why-language-models-hallucinate/
- Artificial Analysis (AA-Omniscience), resultats recollits a OpenRouter: https://openrouter.ai/openai/gpt-6.1-sol
- Villalobos et al. (Epoch AI), Will we run out of data? (ICML 2024): https://proceedings.mlr.press/v235/villalobos24a.html
- IEA, Energy and AI (2025): https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai
- Chroma, Context Rot (7-2025): https://www.trychroma.com/research/context-rot
- Reuters, AMI capta 1.030 M$ (10-3-2026): https://www.reuters.com/business/ex-meta-ai-chief-yann-lecuns-ami-raises-103-billion-alternative-ai-approach-2026-03-10/ · TechCrunch: https://techcrunch.com/2026/03/09/yann-lecuns-ami-labs-raises-1-03-billion-to-build-world-models/ · WIRED: https://www.wired.com/story/yann-lecun-raises-dollar1-billion-to-build-ai-that-understands-the-physical-world/
- Entrevista a Yann LeCun a l’AIM 2026 (fase de recerca d’AMI): https://ceointerviews.ai/interview/2961732/
- Meta, V-JEPA 2 (6-2025): https://arxiv.org/abs/2506.09985 · https://ai.meta.com/blog/v-jepa-2-world-model-benchmarks/
- Date: novembre 2026
- Category: Articles IA


