
Qué hay dentro de una IA: de los LLM a los agentes, y lo que viene después
Una explicación clara de cómo funcionan por dentro los modelos de lenguaje, por qué los modelos actuales razonan antes de responder y cómo se convierten en agentes. Con el estado del arte en noviembre de 2026, sus límites y las tecnologías que vienen.
Qué hay dentro de una IA: de los LLM a los agentes, y lo que viene después
Cómo funcionan ChatGPT, Claude o Gemini, por qué los modelos actuales razonan, cómo se convierten en agentes que trabajan por ti, dónde están sus límites y qué tecnologías podrían sucederles
Casi todos usamos ya alguna inteligencia artificial: para redactar un correo, resumir un PDF o preparar una presentación. Pero pocas personas saben qué ocurre por dentro cuando escribimos una pregunta y aparece una respuesta. Y entenderlo no es un capricho de ingenieros: saber cómo funciona una IA es la mejor manera de saber cuándo fiarse de ella, cuándo no y cómo sacarle partido en una empresa.
Este artículo recorre seis etapas:
- Qué es un LLM y cómo funciona por dentro.
- Por qué los modelos actuales razonan antes de responder, y por qué eso cambia lo que pueden hacer.
- Cómo un LLM se convierte en un agente que hace tareas.
- Cuál es el estado del arte en noviembre de 2026.
- Sus límites teóricos y si estamos cerca de alcanzarlos.
- Las tecnologías que podrían complementarlo o sustituirlo, como los «modelos del mundo» de Yann LeCun.
1. Qué es un LLM y cómo funciona por dentro
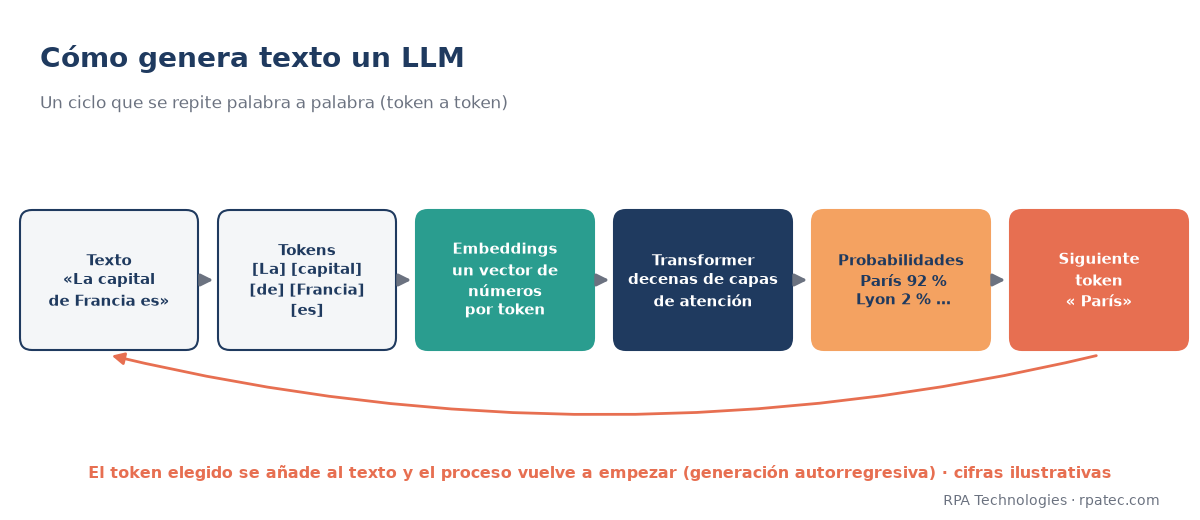
LLM significa Large Language Model, «modelo de lenguaje grande». Es un programa que ha aprendido, a partir de cantidades enormes de texto, a hacer una sola cosa muy bien: predecir cuál es el siguiente fragmento de texto más probable. Todo lo demás, desde responder preguntas hasta escribir código, sale de esa habilidad aplicada una y otra vez.
1.1. Tokens: el texto troceado
El modelo no lee letras ni palabras completas, sino tokens: trozos de texto que pueden ser una palabra corta («la»), parte de una palabra larga («inteli» + «gencia») o un signo de puntuación. Cada modelo tiene un vocabulario fijo de tokens y convierte cualquier texto en una lista de números de ese vocabulario.
Por eso los precios de las IA se expresan en «millones de tokens». Y por eso los modelos antiguos fallaban a menudo al contar las letras de una palabra: nunca vieron las letras, vieron los trozos (lo retomamos en la sección 2).
1.2. Embeddings: el significado convertido en números
Cada token se transforma en un embedding: una lista larga de números (miles) que representa su significado como un punto en un espacio de muchas dimensiones. Durante el entrenamiento, las palabras que aparecen en contextos parecidos acaban en puntos cercanos: «factura» queda cerca de «recibo» y lejos de «montaña».
Esta idea es también la base del RAG (búsqueda en tus propios documentos), del que hablaremos en próximos artículos: si los significados son puntos, buscar información relevante es buscar puntos cercanos.
1.3. El transformer y la atención: leer en contexto
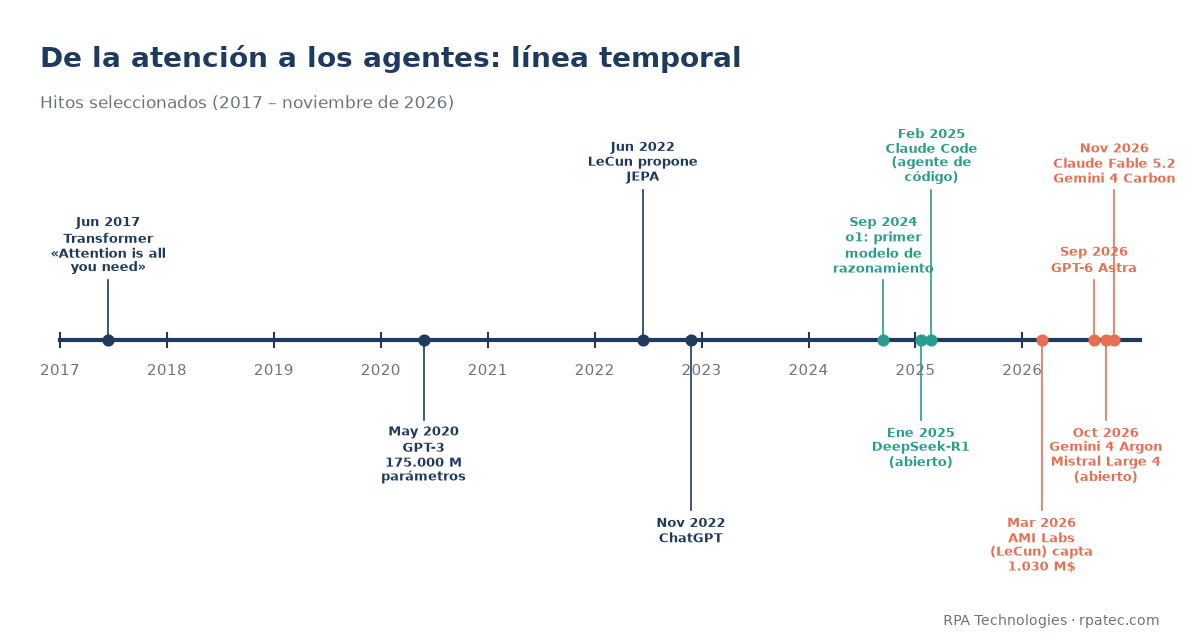
El corazón de casi todos los LLM actuales es el transformer, una arquitectura presentada por investigadores de Google en 2017 en el artículo Attention Is All You Need. Su pieza clave es el mecanismo de atención.
La atención resuelve un problema simple de enunciar: el significado de una palabra depende de las demás. En «Ana dejó el portátil en la mesa porque estaba roto», ¿qué estaba roto? Para interpretar «estaba», el modelo calcula cuánto debe «mirar» a cada una de las palabras anteriores y mezcla su información en esa proporción.
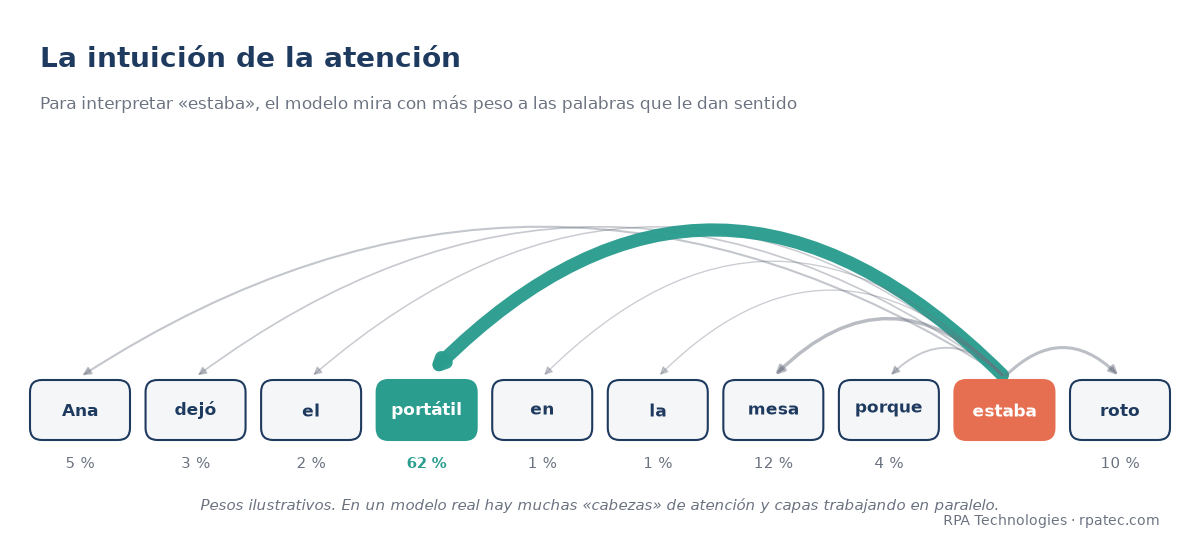
El mecanismo real es matemático: cada token genera tres vectores (una «pregunta», una «clave» y un «valor»); la pregunta de un token se compara con las claves de todos los demás, y cuanto más se parecen, más peso recibe su valor. Esto se repite en muchas «cabezas» en paralelo (una puede fijarse en la gramática, otra en quién hace qué) y en decenas de capas apiladas. Capa a capa, la representación de cada token se va enriqueciendo con el contexto.
Al final, el modelo produce una puntuación para cada token posible del vocabulario, que se convierte en probabilidades. Se elige uno (no siempre el más probable: un poco de azar, la llamada «temperatura», hace las respuestas más naturales), se añade al texto y se repite todo el proceso. Una respuesta de 500 palabras son cientos de vueltas de este ciclo.
1.4. Cómo aprende: las etapas de entrenamiento
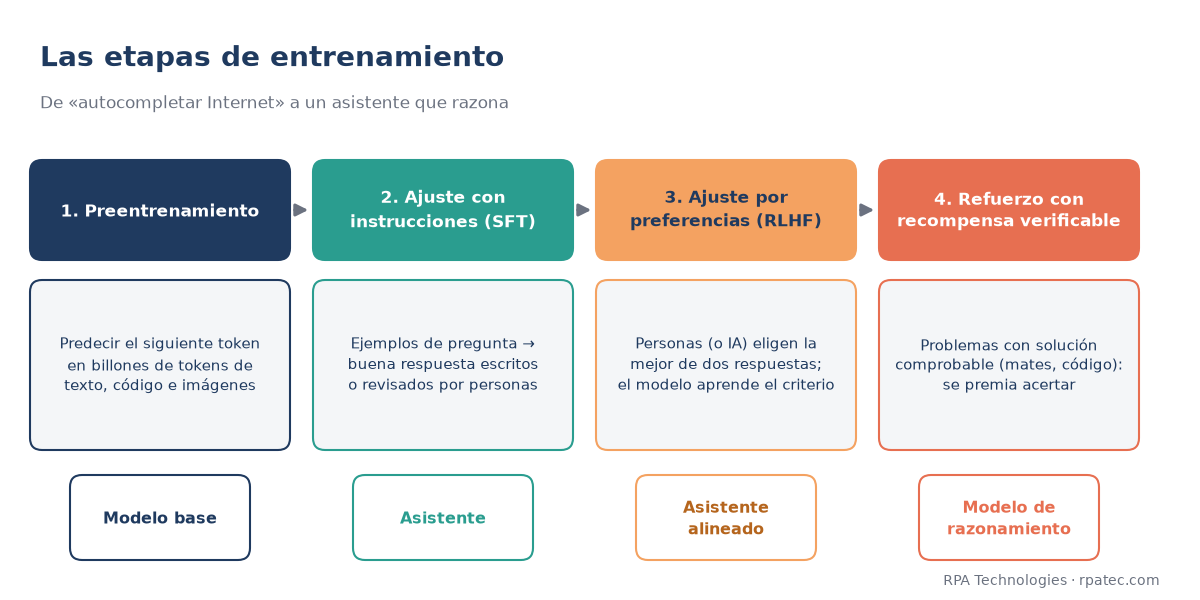
Preentrenamiento. El modelo empieza con miles de millones de parámetros (los «diales» internos) con valores aleatorios. Se le muestra texto real con la última palabra tapada; predice, se compara con la palabra correcta y se ajustan ligeramente todos los parámetros para que la próxima vez acierte un poco más. Repetido billones de veces sobre texto, código e imágenes, el modelo acaba absorbiendo gramática, datos del mundo y patrones de razonamiento. El resultado es un modelo base: un autocompletador muy culto, pero que no sabe conversar.
Ajuste con instrucciones (SFT). Se le entrena con miles de ejemplos de «petición → buena respuesta» escritos o revisados por personas. Aprende el formato de asistente.
Ajuste por preferencias (RLHF). Personas (y cada vez más, otras IA) comparan dos respuestas y eligen la mejor. El modelo aprende ese criterio: ser útil, honesto, no dañino. Es una de las razones de que los asistentes suenen tan amables y, a veces, tan complacientes.
Refuerzo con recompensas verificables. Es la etapa más reciente y la que ha dado lugar a los modelos razonadores. Por su importancia, le dedicamos la sección 2.
1.5. Ventana de contexto
La ventana de contexto es la cantidad máxima de tokens que el modelo puede tener delante a la vez: tu pregunta, los documentos adjuntos, la conversación previa y su propia respuesta. Es su memoria de trabajo. Los modelos de gama alta actuales manejan alrededor de un millón de tokens (por ejemplo, Claude Fable 5.2 o Mistral Large 4), del orden de varios libros. Fuera de esa ventana, el modelo no recuerda nada: no aprende de tus conversaciones a menos que el sistema que lo rodea guarde notas y se las vuelva a mostrar.
💊 Píldora de conocimiento
Un LLM no «busca» respuestas: predice el siguiente token, una y otra vez, usando la atención para leer cada palabra en su contexto. Lo que sabe lo absorbió al entrenarse; lo que tiene delante en la ventana de contexto es su única memoria de trabajo.
2. Modelos razonadores: el eslabón entre predecir palabras y hacer trabajo real
Hasta 2024, un LLM respondía de un tirón: leía la pregunta y empezaba a escribir la respuesta. Los modelos punteros de hoy no funcionan así. Antes de responder, piensan. Y entender esta diferencia es clave, porque los modelos de frontera actuales ya no son «simples LLM»: el razonamiento es lo que les permite usar herramientas con fiabilidad y resolver problemas complejos, y por tanto lo que hace posibles los agentes de la siguiente sección.
2.1. Cómo funcionan
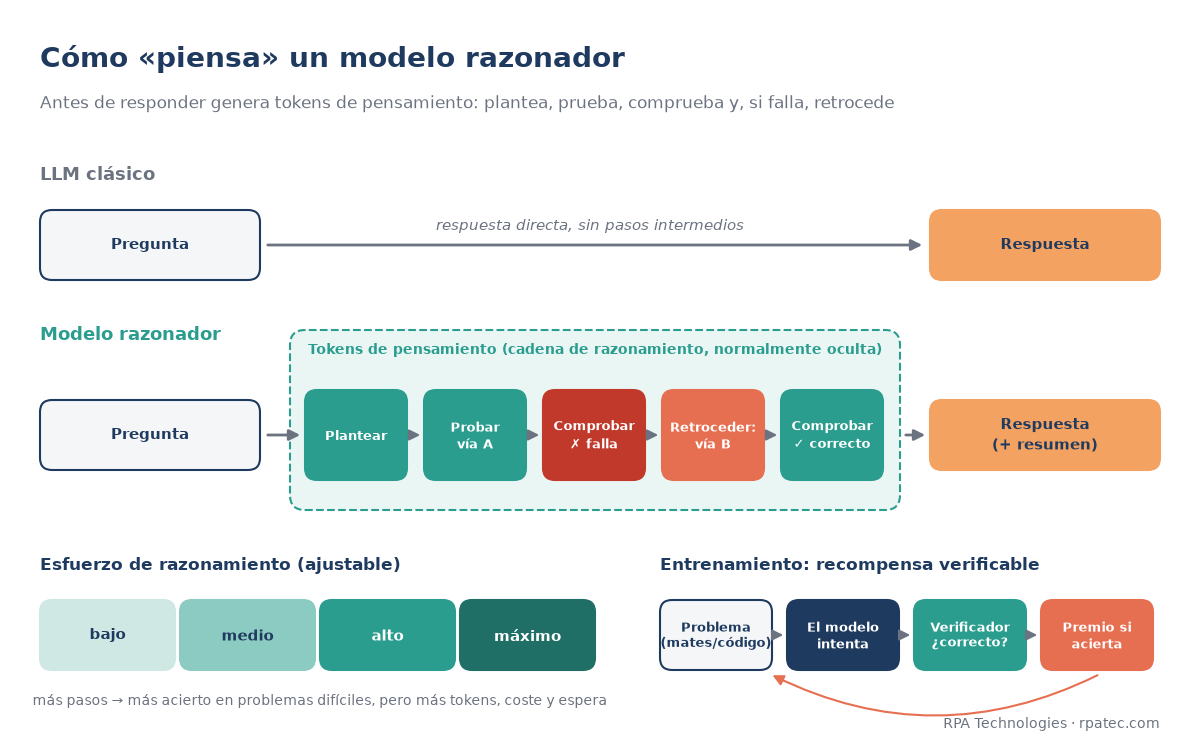
Tokens de pensamiento. Un modelo razonador sigue prediciendo tokens, pero antes de la respuesta genera una cadena de razonamiento (chain of thought): plantea el problema, lo divide en pasos, prueba una vía, la comprueba y, si falla, retrocede y prueba otra. Esos pasos ocupan espacio en la ventana de contexto y normalmente solo ves un resumen. Así lo presentó OpenAI con o1, en septiembre de 2024.
Cómputo en el momento de responder (test-time compute). La gran novedad es que hay una segunda forma de hacer más listo a un modelo: no solo entrenarlo más, sino dejarle pensar más tiempo en cada pregunta.
Refuerzo con recompensas verificables. ¿Cómo se aprende a pensar bien? Se le dan problemas cuya solución se puede comprobar automáticamente (un resultado matemático, un código que debe pasar unas pruebas) y se premian los intentos que aciertan: se premia acertar, no parecer correcto. Nadie le enseña cómo razonar; descubre qué estrategias funcionan. En el caso de DeepSeek-R1-Zero (enero de 2025), entrenado solo con refuerzo, sus autores observaron que el modelo empezó por sí mismo a detenerse y revisar su razonamiento, lo que llamaron un «momento ajá».
Autoverificación y vuelta atrás. El modelo aprende a comprobar resultados intermedios antes de seguir, así que un error temprano ya no arruina toda la respuesta.
Esfuerzo ajustable. Casi todos los modelos actuales permiten elegir cuánto piensan (bajo, medio, alto, máximo). Más esfuerzo significa más acierto en problemas difíciles, pero también más tokens, más coste y más espera.
2.2. Un ejemplo cotidiano: ¿cuántas erres tiene «strawberry»?
Durante años, una pregunta tan sencilla como «¿cuántas erres tiene la palabra inglesa strawberry?» hacía tropezar a modelos muy conocidos, que a menudo respondían «dos». La explicación está en la sección 1: el modelo no recibe letras, sino tokens. Strawberry le llega en unos pocos trozos (por ejemplo, «str» + «aw» + «berry»), así que nunca «ve» las letras sueltas y tiene que adivinar cuántas hay.
Ese fallo era típico, sobre todo, de los modelos antiguos, sin razonamiento, que contestaban de un tirón. Los razonadores actuales casi siempre aciertan, y no porque hayan dejado de usar tokens, sino porque deletrean la palabra paso a paso (s-t-r-a-w-b-e-r-r-y) antes de contar, o recurren a una herramienta, como un pequeño programa, que cuenta por ellos. Es un buen ejemplo de cómo el razonamiento compensa un límite de la propia arquitectura.
2.3. El salto en resultados
- Matemáticas (AIME 2024): GPT-4o resolvía de media el 12 % de los problemas de este examen de olimpiada; o1, el 74 % con un solo intento. En ciencia de nivel doctorado (GPQA Diamond), o1 llegó al 78 % frente al 56 % de GPT-4o y, según OpenAI, fue el primer modelo en superar en esa prueba a los expertos con doctorado que la propia empresa reclutó para compararse.
- DeepSeek-R1 (enero de 2025, modelo abierto) alcanzó el 79,8 % en AIME 2024. Su versión entrenada solo con refuerzo (R1-Zero) pasó del 15,6 % al 71 % durante el entrenamiento, según el informe de enero de 2025; en la versión revisada que se publicó en Nature en septiembre de 2025, R1-Zero llega al 77,9 %.
- ARC-AGI (razonamiento abstracto, fácil para personas y difícil para máquinas): en ARC-AGI-1, GPT-4o rondaba el 5 % en 2024; en diciembre de ese año, una versión preliminar de o3 (o3-preview) marcó un 75,7 %. Cuando se lanzó la versión ARC-AGI-2, más difícil (marzo de 2025), los LLM sin razonamiento sacaban un 0 % y los razonadores, un solo dígito. Hoy, según la clasificación del propio ARC Prize (consultada el 11 de noviembre de 2026), la encabeza GPT-6 Astra con un 95 %, seguido de GPT-6.1 Sol y Gemini 4 Carbon (94,2 % cada uno) y Claude Fable 5.2 (93,8 %).
- Programación real (SWE-bench Verified), que consiste en resolver incidencias reales de proyectos de software: GPT-4o resolvía el 33,2 % en agosto de 2024 y DeepSeek-R1 llegó al 49,2 % en enero de 2025. En la evaluación independiente de Vals AI (actualizada el 1 de septiembre de 2026), Claude Opus 5 resolvió el 97 %, hasta el punto de que Vals dejó de usar esta prueba por estar saturada. Las cifras dependen de quién mide y con qué harness: el tablero oficial de SWE-bench, que se actualiza con menos frecuencia, muestra un máximo del 79,2 %.
2.4. El precio de pensar
Pensar cuesta, porque los tokens de pensamiento se pagan como texto generado aunque no los veas. El caso más ilustrativo es aquella versión preliminar de o3 en ARC-AGI-1 (diciembre de 2024): según las estimaciones de ARC Prize, un 75,7 % costaba unos 26 $ por tarea; subir al 87,5 % exigió unas 172 veces más cómputo, unos 4.560 $ por tarea. El coste ha bajado mucho desde entonces, pero la lógica sigue siendo la misma: más acierto a cambio de más dinero y más segundos (o minutos) de espera. Para preguntas sencillas, un nivel de esfuerzo bajo suele bastar.
2.5. Sus límites
- Capacidades irregulares. Los modelos resuelven problemas de matemáticas de olimpiada y, a la vez, fallan en tareas que a una persona le parecen triviales. Las capacidades son irregulares (jagged, dice METR): brillantes en tareas bien definidas y comprobables, donde el refuerzo funciona mejor (matemáticas, código), y más torpes en tareas ambiguas, largas y con poco contexto, que son justamente las del día a día de una empresa. Ahí la mejora es menor y la revisión humana sigue siendo imprescindible.
- El razonamiento visible no siempre es el real. En un estudio de Anthropic de 2025, cuando a los modelos se les daba una pista con la respuesta y la usaban, solo la mencionaban en su razonamiento el 25 % de las veces (Claude 3.7 Sonnet) y el 39 % (DeepSeek-R1). La cadena de pensamiento ayuda a supervisar, pero no es una confesión fiel.
- Sobrepensar. Los razonadores a veces gastan cientos de tokens en preguntas triviales, como describe el estudio Do NOT Think That Much for 2+3=? (2024).
2.6. Por qué importa para los agentes
Un agente encadena decenas de pasos: buscar un dato, abrir un fichero, ejecutar un cálculo, comprobar el resultado. Si cada paso tiene una pequeña probabilidad de error, sin capacidad de detectarlo y corregirlo el fallo se acumula. El razonamiento aporta justo eso: planificar antes de actuar, comprobar lo que devuelve cada herramienta y rectificar. Es el puente entre «predecir la siguiente palabra» y «terminar un trabajo».
💊 Píldora de conocimiento
Los modelos de frontera actuales piensan antes de responder: generan pasos intermedios, los comprueban y rectifican. Lo aprendieron con refuerzo sobre problemas verificables, y es lo que les permite usar herramientas con fiabilidad. Puedes regular cuánto piensan: más esfuerzo da más acierto, pero también más coste y más espera.
3. De LLM a agente: el papel del «harness»
Un LLM, por sí solo, solo produce texto. No puede abrir tu correo, consultar una base de datos ni guardar un fichero. Para que haga cosas necesita un harness (literalmente, «arnés»): el programa que lo rodea y lo conecta con el mundo.
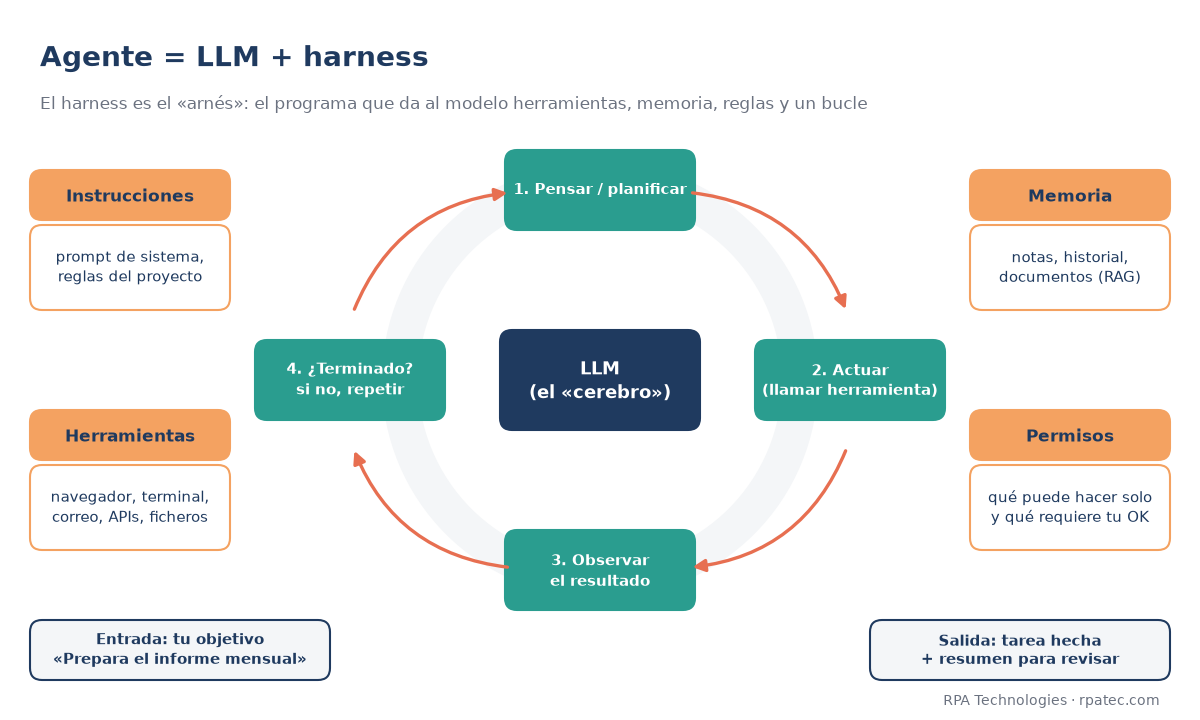
Un harness tiene cinco piezas:
- El bucle. El harness pasa al modelo el objetivo, el modelo decide un paso, el harness lo ejecuta, devuelve el resultado al modelo y se repite hasta terminar. Este ciclo de pensar → actuar → observar es lo que convierte una respuesta en un trabajo.
- Herramientas. Funciones que el modelo puede pedir que se ejecuten: buscar en la web, leer un PDF, lanzar un comando, enviar un borrador. El modelo no las ejecuta: escribe una petición estructurada («llama a buscar_factura con el cliente X») y el harness la ejecuta. Desde finales de 2024 existe un estándar abierto, el Model Context Protocol (MCP), que permite conectar herramientas a casi cualquier agente.
- Instrucciones. El «prompt de sistema» y los ficheros de reglas del proyecto: quién es, cómo trabaja, qué estilo usa.
- Memoria. Notas que el agente guarda y relee, historial o documentos indexados. Como el modelo olvida todo fuera de su ventana de contexto, la memoria la gestiona el harness.
- Permisos. Qué puede hacer solo y qué necesita tu aprobación. Es la pieza más importante en una empresa: un agente con acceso a tu correo sin control de permisos es un riesgo.
Un dato revelador: el mismo modelo rinde muy distinto según el harness. Por eso organizaciones de evaluación como METR prueban los modelos dentro de distintos harness (por ejemplo, Claude Code o Codex) antes de medir lo que son capaces de hacer.
Ejemplos disponibles hoy (noviembre de 2026)
- Agentes de programación: Claude Code (Anthropic), Codex (OpenAI, con una versión de línea de comandos de código abierto), Cursor (editor con agentes locales y en la nube) y Antigravity (Google). Leen un proyecto entero, modifican archivos, ejecutan pruebas y proponen cambios para revisión.
- Agentes de trabajo general en la nube: Manus, Claude Cowork, Dots de OpenAI, Muse de Meta o Grok Bot. Tienen su propio ordenador virtual con navegador y archivos, y hacen tareas como investigar, rellenar hojas de cálculo o preparar informes.
- Agentes de código abierto y autoalojados: OpenClaw y Hermes Agent (de Nous Research), ambos con licencia MIT. Se instalan en tu ordenador o servidor, admiten muchos modelos (incluidos modelos locales) y se manejan desde WhatsApp, Telegram, Slack o Teams. Son interesantes cuando la privacidad y el control de los datos importan.
- Plataformas empresariales: Mistral, por ejemplo, anunció el 5 de noviembre Mistral Studio para crear agentes gestionados, en su nube o en tus propios servidores.
💊 Píldora de conocimiento
Agente = LLM + harness. El modelo decide; el harness ejecuta, recuerda y pone límites. Cuando evalúes una herramienta de IA para tu empresa, pregunta tanto por el modelo como por el harness: qué herramientas usa, dónde guarda la memoria y qué puede hacer sin pedirte permiso.
4. El estado del arte en noviembre de 2026
El ritmo es vertiginoso: solo en la primera quincena de noviembre han salido varios modelos punteros. Esta es una foto, no una clasificación definitiva.
Los modelos de frontera (cerrados):
- Google · Gemini 4 Carbon (10 de noviembre) y Gemini 4 Argon (13 de octubre). Carbon está orientado a tareas agénticas largas y ciberseguridad, y encabeza la clasificación de texto de LMArena, donde personas votan a ciegas entre dos respuestas, con 1.526 puntos (datos del 9 de noviembre), por delante de Argon (1.522).
- Anthropic · Claude Fable 5.2 (9 de noviembre), con un millón de tokens de contexto, hasta 128.000 de salida y razonamiento adaptativo, a 8 $/40 $ por millón de tokens de entrada/salida. Anthropic afirma que en sus pruebas previas formalizó la demostración del último teorema de Fermat en 30 horas. Es una afirmación de la empresa, pendiente de verificación independiente. Su gemelo Mythos 5.2 solo se ofrece a organizaciones verificadas en ciberseguridad y biomedicina.
- OpenAI · GPT-6 Astra (3 de septiembre) y GPT-6.1 Sol (29 de septiembre), que según OpenAI casi iguala a Astra en programación agéntica a una quinta parte del precio. GPT-6 Cyber (5 de noviembre) está restringido a clientes aprobados.
- Meta · Muse (Muse Wonder, Muse Spark) y xAI · Grok 4.7 (21 de septiembre).
Los modelos abiertos (pesos descargables, que puedes ejecutar en tus servidores) están a poca distancia: Mistral Large 4, europeo, liberado el 29 de octubre, con un billón de parámetros (de los que solo unos 50.000 millones trabajan en cada token, gracias a la técnica Mixture of Experts) y un millón de tokens de contexto. Le acompañan Kimi K3, GLM 5.3, DeepSeek V4 o Qwen 3.8. En LMArena, el mejor modelo abierto (Kimi K3) está unos 40 puntos por debajo del primero.
Tres tendencias que importan a una pyme:
- La capacidad de trabajo autónomo crece de forma exponencial. METR mide la duración de las tareas (medida en tiempo de un experto humano) que un agente completa con un 50 % de éxito. En su actualización de enero de 2026, esa duración se duplicaba cada ~196 días desde 2019 y cada ~89 días desde 2024. METR ya advierte que sus mediciones por encima de 16 horas no son fiables con su batería de tareas actual: los mejores modelos se están quedando sin examen.
- El precio por capacidad cae. Modelos intermedios como GPT-6.1 Sol (2 $/10 $ por millón de tokens) rinden casi como los de gama alta de hace unas semanas.
- Lo abierto alcanza a lo cerrado con unos meses de retraso, lo que hace viable la IA local para datos sensibles.
💊 Píldora de conocimiento
Hoy no hay un «mejor modelo» único: Google lidera en preferencia de usuarios, Anthropic y OpenAI compiten en agentes y programación, y los modelos abiertos (como el europeo Mistral Large 4) están a pocos meses. Para una empresa, la pregunta útil no es «¿cuál es el mejor?», sino «¿cuál es suficiente para esta tarea, a qué coste y con qué privacidad?».
5. Límites teóricos: ¿estamos cerca del techo?
5.1. Alucinaciones
Un LLM puede afirmar con total seguridad algo falso. No es un fallo puntual, sino una consecuencia de su diseño: el modelo genera el texto más plausible, y lo plausible no siempre es verdad. Un artículo de OpenAI de septiembre de 2025 añade una causa: los exámenes con los que se evalúan los modelos premian acertar y no dan nada por decir «no lo sé», así que el entrenamiento recompensa adivinar. Su propuesta es penalizar más el error seguro que la abstención.
Ha mejorado mucho, pero no ha desaparecido. En la prueba AA-Omniscience de Artificial Analysis, incluso un modelo puntero como GPT-6.1 Sol, cuando no conoce la respuesta, se abstiene solo en torno a la mitad de las veces; el resto, inventa. Conclusión práctica: para datos de tu empresa, la IA debe citar documentos (RAG) y una persona debe revisar lo importante.
5.2. No hay un modelo del mundo… o no del todo
Un LLM aprende del lenguaje, que es una descripción parcial del mundo. Sabe que un vaso que cae «se rompe» porque lo ha leído mil veces, no porque entienda la gravedad. Este es el argumento central de Yann LeCun: el texto es demasiado pobre para aprender física, causalidad y planificación como lo hace un niño observando. El debate sigue abierto: los modelos actuales, entrenados también con imágenes y vídeo, muestran cierta comprensión física, pero frágil.
5.3. El muro de datos
Epoch AI estima que el texto público de calidad escrito por humanos se agotará como recurso de entrenamiento hacia 2028 (en un rango de 2026 a 2032). La industria responde con datos sintéticos (generados por otras IA), con datos privados y multimodales (vídeo, audio) y, sobre todo, con aprendizaje por refuerzo, donde el modelo genera sus propios intentos y aprende de los que funcionan. El muro existe, pero se está rodeando.
5.4. Leyes de escala, cómputo y energía
Desde 2020 se sabe que los modelos mejoran de forma predecible al aumentar parámetros, datos y cómputo, pero con rendimientos decrecientes: cada mejora cuesta muchas veces más. El coste físico es real: la Agencia Internacional de la Energía (IEA) prevé que el consumo eléctrico de los centros de datos pase de unos 415 TWh en 2024 a unos 945 TWh en 2030, algo menos del 3 % de la electricidad mundial. La IA es el principal motor de ese aumento.
El razonamiento y el refuerzo (sección 2) han abierto nuevas palancas de mejora, pero también consumen cómputo: pensar más tiempo en cada respuesta multiplica el gasto.
5.5. El contexto no es memoria perfecta
Que un modelo acepte un millón de tokens no significa que los use todos igual de bien. El estudio Context Rot de Chroma (julio de 2025) probó 18 modelos y vio que todos rinden peor a medida que crece la entrada, incluso en tareas sencillas. Por eso un buen agente no «lo mete todo en el contexto»: selecciona, resume y busca lo relevante. A eso se le llama ingeniería de contexto.
¿Cerca del techo?
Las métricas de capacidad no muestran estancamiento: el horizonte de tareas de METR sigue creciendo exponencialmente y los modelos de noviembre superan a los de septiembre. Pero las limitaciones estructurales (alucinación, falta de un modelo físico del mundo, aprendizaje que se detiene tras el entrenamiento, capacidades irregulares y coste energético) no se resuelven solo con escala. La lectura más honesta es: queda mucho margen de mejora dentro del paradigma actual, pero probablemente no basta para llegar a una inteligencia general. De ahí el interés por las alternativas.
💊 Píldora de conocimiento
Las IA actuales siguen mejorando muy deprisa, pero arrastran límites de diseño: inventan cuando no saben, aprenden del texto y no del mundo, y consumen mucha energía. Para tu empresa: úsalas con fuentes citadas, revisión humana en lo crítico y una buena gestión del contexto.
6. Lo que viene: tecnologías que pueden complementar o sustituir a los LLM
6.1. JEPA y los modelos del mundo de Yann LeCun
Yann LeCun, premio Turing y durante años científico jefe de IA en Meta, dejó la compañía en noviembre de 2025 y fundó en París AMI Labs (Advanced Machine Intelligence). En marzo de 2026 la empresa captó 1.030 millones de dólares con una valoración previa de 3.500 millones, con oficinas en París, Nueva York, Montreal y Singapur. Su objetivo declarado: sistemas que entiendan el mundo, tengan memoria persistente, razonen, planifiquen y sean controlables.
Su propuesta técnica es JEPA (Joint Embedding Predictive Architecture), presentada por LeCun en 2022.
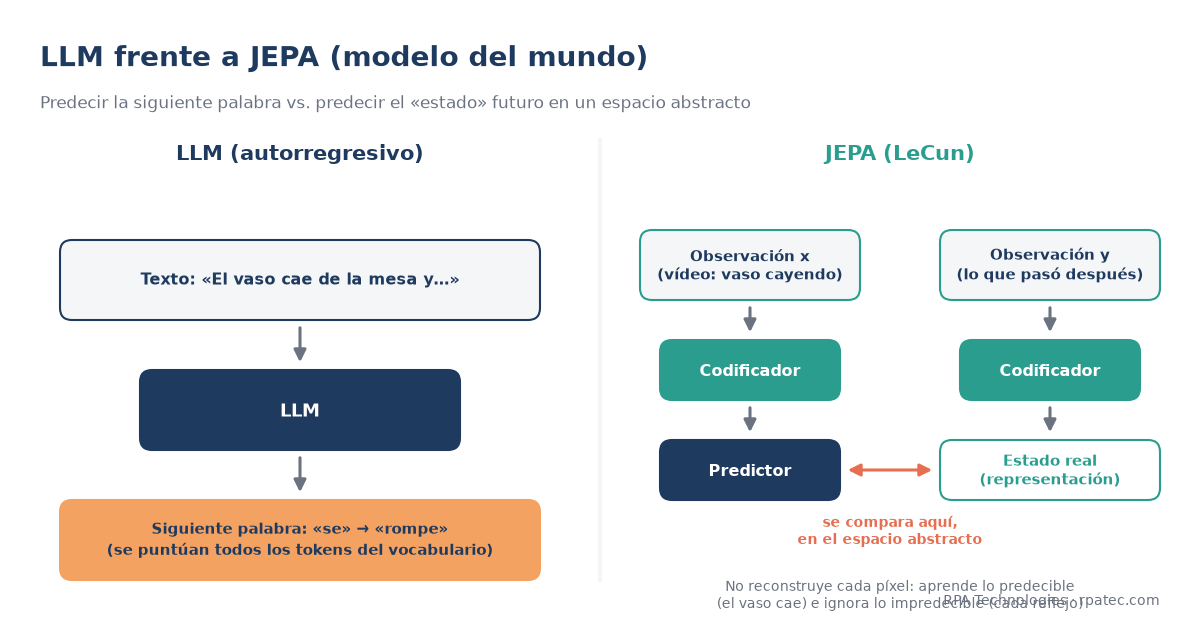
La diferencia clave: un LLM predice el siguiente token, es decir, el detalle exacto. JEPA no intenta predecir cada píxel del siguiente fotograma de un vídeo, porque el mundo real tiene infinitos futuros posibles y la mayoría de sus detalles (el reflejo exacto en un cristal) son impredecibles. En su lugar, convierte la observación actual y la futura en representaciones abstractas y aprende a predecir una a partir de la otra en ese espacio abstracto. Así se queda con lo predecible (el vaso cae) e ignora el ruido. Con un modelo así, un sistema puede planificar: imaginar las consecuencias de varias acciones y elegir la mejor.
Hay resultados concretos: V-JEPA 2 (Meta, junio de 2025), entrenado con vídeo y ajustado con solo 62 horas de datos de robots, logró que brazos robóticos cogieran y colocaran objetos en laboratorios nuevos sin entrenamiento específico, con tasas de éxito del 65-80 % en esa tarea. Pero AMI Labs reconoce que está en fase de investigación, sin productos a corto plazo: primero publicaciones científicas y después aplicaciones industriales (fabricación, automoción, aeronáutica, salud) con socios como la empresa de salud digital Nabla.
6.2. Otras líneas que conviene conocer
- Modelos basados en energía (EBM). Otra idea defendida por LeCun: en lugar de generar una respuesta, el sistema puntúa cuánto «encaja» cada respuesta posible con la pregunta (baja energía significa compatible) y busca la mejor. Permite razonar como optimización, no solo como escritura palabra a palabra.
- Modelos de espacio de estados (SSM, como Mamba). Sustituyen o combinan la atención con una «memoria comprimida» que se actualiza paso a paso. Su coste crece de forma lineal con la longitud del texto, en lugar de dispararse como en la atención clásica. Ya existen modelos híbridos transformer + Mamba en producción.
- Modelos de lenguaje de difusión. En lugar de escribir de izquierda a derecha, generan un borrador completo y lo refinan en paralelo, como los generadores de imágenes. Son mucho más rápidos. Ejemplos: Mercury, de Inception, y el experimental Gemini Diffusion de Google.
- IA neurosimbólica. Combina redes neuronales con lógica formal y reglas verificables. Ya la vemos en la práctica: modelos que escriben demostraciones en lenguajes formales (como Lean) que un verificador automático comprueba. Es una vía directa contra las alucinaciones en tareas donde la corrección importa.
¿Sustituir o complementar? Lo más probable a medio plazo es una combinación: LLM como interfaz de lenguaje y orquestador, modelos del mundo para lo físico y la planificación, verificadores simbólicos para lo que debe ser exacto, y arquitecturas más eficientes para abaratar el coste. Los agentes de hoy ya funcionan así: un modelo que coordina herramientas especializadas.
💊 Píldora de conocimiento
Yann LeCun apuesta por modelos del mundo (JEPA) que aprenden observando y predicen en abstracto, no palabra a palabra. Es investigación prometedora, con robots que ya planifican tareas sencillas, pero sin productos todavía. El futuro probable no es «LLM o alternativa», sino sistemas híbridos.
En resumen
- Un LLM predice el siguiente token usando atención sobre su contexto. Todo lo demás se construye encima.
- Los modelos razonadores piensan antes de responder: generan pasos intermedios, los comprueban y rectifican. Por eso los modelos de frontera ya no son «simples LLM».
- Un agente es un LLM con un harness: bucle, herramientas, memoria, instrucciones y permisos.
- En noviembre de 2026 la frontera la marcan Google, Anthropic y OpenAI, con los modelos abiertos a pocos meses, lo que abre la puerta a la IA privada y local.
- Los límites (alucinaciones, datos, energía, comprensión del mundo) son reales, pero aún hay margen dentro del paradigma actual.
- Lo que viene (modelos del mundo, SSM, difusión, neurosimbólica) apunta a sistemas híbridos.
En RPA Technologies ayudamos a pymes y profesionales a aplicar todo esto con los pies en el suelo: asistentes y agentes que trabajan con tus documentos, IA local cuando la privacidad lo exige, y formación para que tu equipo entienda lo que usa. Si quieres que tratemos un tema concreto, déjalo en comentarios.
👉 Más información en rpatec.com
Fuentes
Ordenadas según aparecen en el artículo. Datos de clasificaciones consultados el 11-11-2026.
- Vaswani et al., Attention Is All You Need (2017): https://arxiv.org/abs/1706.03762
- OpenAI, Learning to reason with LLMs (12-9-2024): https://openai.com/index/learning-to-reason-with-llms/
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (1-2025): https://arxiv.org/abs/2501.12948 · versión revisada en Nature (9-2025), tabla por etapas: https://www.nature.com/articles/s41586-025-09422-z/tables/2
- ARC Prize, OpenAI o3 Breakthrough High Score on ARC-AGI-Pub (20-12-2024): https://arcprize.org/blog/oai-o3-pub-breakthrough
- ARC Prize, Announcing ARC-AGI-2 and ARC Prize 2025 (24-3-2025): https://arcprize.org/blog/announcing-arc-agi-2-and-arc-prize-2025
- ARC Prize, clasificación y resultados: https://arcprize.org/leaderboard · https://arcprize.org/results
- OpenAI, Introducing SWE-bench Verified (13-8-2024): https://openai.com/index/introducing-swe-bench-verified/
- Vals AI, SWE-bench Verified (archivado; actualizado el 1-9-2026): https://www.vals.ai/benchmarks/swebench
- SWE-bench, tableros oficiales: https://www.swebench.com/
- METR, Time Horizon 1.1 (29-1-2026): https://metr.org/blog/2026-01-29-time-horizon-1-1/ · https://metr.org/time-horizons/
- Anthropic, Reasoning models don’t always say what they think (2025): https://www.anthropic.com/research/reasoning-models-dont-say-think · https://arxiv.org/abs/2505.05410
- Chen et al., Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs (12-2024): https://arxiv.org/abs/2412.21187
- Comparativas de agentes y harness (2026): https://hermes-agent.nousresearch.com/compare · https://insights.reinventing.ai/ai-agent-harnesses
- Mistral Studio y lanzamientos de noviembre (recopilación): https://ai.vi.ki/releases
- Google, Gemini 4 Carbon is now available (10-11-2026): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- Google, Gemini 4 Argon (13-10-2026): https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/
- LMArena Text leaderboard (vía BenchLeader, datos del 9-11-2026): https://www.benchleader.com/benchmarks/lmarena_text
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2 (9-11-2026): https://www.anthropic.com/claude-fable-and-mythos-5-2 · ficha técnica: https://platform.claude.com/docs/en/models/fable-5-2/overview
- OpenAI, GPT-6 Astra (3-9-2026): https://openai.com/index/gpt-6-astra/ · Introducing GPT-6.1 Sol (29-9-2026): https://openai.com/index/introducing-gpt-6-1-sol/
- xAI, Introducing Grok 4.7: https://x.ai/news/grok-4-7
- Mistral AI, Mistral Large 4 is now open weight (29-10-2026): https://mistral.ai/news/mistral-large-4-oss/
- OpenAI, Why language models hallucinate (9-2025): https://openai.com/index/why-language-models-hallucinate/
- Artificial Analysis (AA-Omniscience), resultados recogidos en OpenRouter: https://openrouter.ai/openai/gpt-6.1-sol
- Villalobos et al. (Epoch AI), Will we run out of data? (ICML 2024): https://proceedings.mlr.press/v235/villalobos24a.html
- IEA, Energy and AI (2025): https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai
- Chroma, Context Rot (7-2025): https://www.trychroma.com/research/context-rot
- Reuters, AMI capta 1.030 M$ (10-3-2026): https://www.reuters.com/business/ex-meta-ai-chief-yann-lecuns-ami-raises-103-billion-alternative-ai-approach-2026-03-10/ · TechCrunch: https://techcrunch.com/2026/03/09/yann-lecuns-ami-labs-raises-1-03-billion-to-build-world-models/ · WIRED: https://www.wired.com/story/yann-lecun-raises-dollar1-billion-to-build-ai-that-understands-the-physical-world/
- Entrevista a Yann LeCun en AIM 2026 (fase de investigación de AMI): https://ceointerviews.ai/interview/2961732/
- Meta, V-JEPA 2 (6-2025): https://arxiv.org/abs/2506.09985 · https://ai.meta.com/blog/v-jepa-2-world-model-benchmarks/
- Date: noviembre 2026
- Category: Artículos IA


